跳到主要内容

79 篇博文 含有标签「前端」

前端开发技术文章

查看所有标签

clsx 库如何使用

· 阅读需 1 分钟
素明诚
Full stack development

示例​

假设我们有一个用户卡片组件,它可以显示为正常、高亮或禁用状态。基于这些状态,卡片的样式类将会改变。

使用 clsx,我们可以轻松地构建这个组件的类名。

import clsx from 'clsx';

function UserCard({ highlighted, disabled, username }) {
const className = clsx('user-card', {
'highlighted': highlighted,
'disabled': disabled,
'normal': !highlighted && !disabled
});

return <div className={className}>{username}</div>;
}

在上述例子中:

  1. 如果 highlighted 属性为 true,类名将包括 highlighted。
  2. 如果 disabled 属性为 true,类名将包括 disabled。
  3. 如果都不是 highlighted 和 disabled,类名将包括 normal。

所以,当你这样使用组件:

<UserCard highlighted={true} username="Alice" />

生成的 HTML 将是:

<div class="user-card highlighted">Alice</div>

通过 clsx,我们可以有条件地、清晰地和简洁地构建类名,而不需要冗长或重复的代码逻辑。

而且该库很小,兼容性也很好,是完美的classnames 替代品。

这个库在 React 社区中很受欢迎,因为 React 经常需要动态地构建类名

v-model 和 v-modellazy 的区别

· 阅读需 2 分钟
素明诚
Full stack development

v-model: 默认情况下,v-model 在每次输入事件 (input) 发生时都会更新数据。这意味着当用户在输入框中每次按键时,数据都会实时更新。

v-model.lazy: .lazy 修饰符会更改 v-model 的行为,使其在 change 事件而不是 input 事件上同步。这意味着数据只有在输入框失去焦点或用户按下回车键时才会更新,而不是用户每次键入字符时。

区别很简单,但是为什么非要有个lazy呢?

lazy 背后的考虑​

  1. 性能考虑: 在某些情况下,实时处理每一个 input 事件可能是性能昂贵的。例如,如果输入绑定到一个复杂的计算属性或触发一系列的 DOM 变动,每次键入都会导致这些操作执行,这可能导致不必要的计算和渲染。通过使用 .lazy,你可以确保只在必要时执行这些操作,例如当用户完成输入并移出输入框时。
  2. 用户体验: 在某些应用中,你可能不希望在用户还在输入时即刻给出反馈(例如,实时的表单验证)。有时,直到用户完成输入并移出输入框,你才开始显示验证消息,这样可以避免中途打断用户。
  3. 控制: Vue 提供了一系列的修饰符(如 .lazy, .number, .trim),这样开发者可以根据需要精确地控制输入的行为。不是所有应用都需要实时的输入同步,.lazy 修饰符为那些需要更细粒度控制的场景提供了选择。
  4. 与其他库/框架的一致性: 其他前端框架和库中的双向数据绑定机制通常不会在每次键入时都更新数据,而是在某些特定事件(如失去焦点)时才更新。.lazy 修饰符为那些从其他框架迁移到 Vue 的开发者提供了熟悉的行为。

为什么 JavaScript 的0 和 -0 是相等的

· 阅读需 1 分钟
素明诚
Full stack development

+0 和 -0 这两个是特殊情况,虽然他们两个相等,但是他们两个有特殊的意义才这么设计的

ffd5be6bfa26e251140129416440fe45## 为什么需要两种零的表示:

  1. 表示特定的数学极限: 如之前所述,考虑函数 1/x。当 x 从正数接近零时,结果趋向于正无穷。而当 x 从负数接近零时,结果趋向于负无穷。这种区分允许计算机模拟这些数学上的极限行为。
  2. 数值稳定性: 在某些数值算法中,保留 +0 和 -0 的区分可以提供更准确和稳定的结果。
  3. 位级表示: 在 IEEE 754 标准中,+0 和 -0 在位级上有所不同,尤其是在符号位上。这种区别使得我们可以在不牺牲其他功能的情况下,明确地表示和区分这两种零。

虽然这种比较,从人直觉的角度很不一致,但是这么设计的目标是为了解决数学和数值计算中的特定问题

padStart 和 padEnd

· 阅读需 2 分钟
素明诚
Full stack development

padStart 和 padEnd 是 ES8 (ES2017) 中引入的两个字符串原型方法。它们用于在字符串的开头或结尾填充指定的字符,直到字符串达到给定的长度。这两个方法常用于格式化输出。

padStart 和 padEnd 是 ES8 (ES2017) 中引入的两个字符串原型方法。它们用于在字符串的开头或结尾填充指定的字符,直到字符串达到给定的长度。这两个方法常用于格式化输出。

1.padStart(targetLength [, padString])​

这个方法会在当前字符串的开头填充字符,直到字符串达到 targetLength 的长度。如果填充的字符串 padString 没有指定,那么默认使用空格进行填充。

示例:​

'5'.padStart(2, '0');       // '05'
'123'.padStart(5, '0'); // '00123'
'abc'.padStart(6, '01'); // '01abc'
'abcdef'.padStart(4, '0'); // 'abcdef', 因为原字符串已经超过或等于目标长度,所以返回原字符串

2.padEnd(targetLength [, padString])​

这个方法会在当前字符串的结尾填充字符,直到字符串达到 targetLength 的长度。如果填充的字符串 padString 没有指定,那么默认使用空格进行填充。

示例:​

'5'.padEnd(2, '0');       // '50'
'123'.padEnd(5, '0'); // '12300'
'abc'.padEnd(6, '01'); // 'abc010'
'abcdef'.padEnd(4, '0'); // 'abcdef', 因为原字符串已经超过或等于目标长度,所以返回原字符串

这两个方法在处理数字、日期等格式时非常有用,它们可以确保输出的字符串具有统一的长度和格式。

实现字符串大数相加

· 阅读需 1 分钟
素明诚
Full stack development

流程如下:

  1. 初始化进位 carry 为 0。
  2. 使用 padStart 方法确保两个数字字符串长度相同。
  3. 从低位到高位(也就是从字符串的最后一位到第一位)进行遍历,并执行加法。
  4. 计算当前位的结果,如果大于 9 则产生进位。
  5. 如果遍历完所有位后仍有进位,则添加到结果的最前面。
function bigNumberAddition(num1, num2) {
let carry = 0 // 初始化进位
let result = []

// 使两个数字字符串长度相同
const length = Math.max(num1.length, num2.length)
num1 = num1.padStart(length, '0')
num2 = num2.padStart(length, '0')

// 从低位到高位进行相加
for (let i = length - 1; i >= 0; i--) {
let tempSum = parseInt(num1[i]) + parseInt(num2[i]) + carry
result.unshift(tempSum % 10) // 取模得到当前位
console.log(result)
carry = Math.floor(tempSum / 10) // 取整得到进位
}

// 如果最后仍有进位,添加到结果前面
if (carry) {
result.unshift(carry)
}

return result.join('')
}

// 测试
const numA = '99'
const numB = '99'
const sum = bigNumberAddition(numA, numB)
console.log(sum)

Indexdts 为什么要写 export

· 阅读需 2 分钟
素明诚
Full stack development

在 TypeScript 中,当你在一个 .ts 或 .d.ts 文件中使用 export 关键字,该文件会被视为一个模块。相反地,如果文件中没有 export 或 import 语句,那么它会被视为一个全局脚本,其中的所有声明都会被加入到全局命名空间。

在 .d.ts 文件中,通常我们希望为模块或库定义类型,而不是为全局命名空间添加内容。

但是,有时候,我们可能只是想声明一些全局的接口或类型,而不实际导出任何内容。在这种情况下,只写类型声明可能会导致 TypeScript 将这个文件误认为是全局脚本。

为了避免这个问题,但又不实际导出任何东西,我们可以使用一个空的 export {} 语句。这会将文件标记为模块,从而确保文件内的所有声明都仅在该模块中可见,而不是被加入到全局命名空间。

所以,export {} 的主要目的是确保 .d.ts 文件被视为一个模块,而不是全局脚本,从而避免意外地将声明加入到全局命名空间。

深入理解 await 与 async

· 阅读需 4 分钟
素明诚
Full stack development

1. 基本概念​

什么是 async 函数?​

async 函数是一个返回 Promise 对象的函数。在函数内部,你可以使用 await 关键字来等待一个 Promise。

什么是 await 关键字?​

await 关键字只能在 async 函数内部使用,它会暂停当前函数的执行直到 Promise 完成,并返回结果。

async 函数返回什么类型的值?​

async 函数总是返回一个 Promise。


2. 错误处理​

如何在使用 await 时处理错误?​

使用 try/catch 结构。

try/catch 在 async/await 中的作用是什么?​

它用于捕获 await 表达式中的错误或在 async 函数内部抛出的错误。

如何处理多个 await 调用中的并发错误?​

  1. 如果你使用 Promise.all() 来同时等待多个 Promise,它会在其中一个 Promise 失败时立即失败。
  2. 你可以在这种情况下使用 try/catch 来捕获错误。

3. 并发性​

如何并发地执行多个 await 操作?​

你可以使用 Promise.all() 或者 Promise.allSettled() 来并发执行多个 Promise。

Promise.all()和 Promise.race()在与 async/await 结合时有什么作用?​

  1. Promise.all() 允许你并发等待多个 Promise,它返回一个 Promise,该 Promise 在所有的 Promise 完成后完成。
  2. Promise.race() 返回一个 Promise,该 Promise 在第一个 Promise 完成后完成。

4. 与 Promise 的关系​

async/await 和 Promises 之间有什么关系?​

async/await 是基于 Promise 的,并提供了一种更简洁、更直观的方式来处理 Promise。

在 async 函数中返回一个值等价于哪种 Promise 操作?​

  1. 返回一个值等价于 Promise.resolve()。
  2. 抛出错误等价于 Promise.reject()。

5. 执行顺序​

描述一个包含多个 await 语句的 async 函数的执行顺序。​

函数会从顶部开始执行,当遇到第一个 await 语句时暂停,直到该 Promise 完成。然后,函数会继续执行,直到遇到下一个 await 或函数结束。

何时使用 await 和何时避免使用?​

  1. 当你需要按顺序执行异步操作时,使用 await。
  2. 当你可以并发执行多个操作时,使用 Promise.all() 或其他类似的方法。

6. 错误和陷阱​

描述在使用 async/await 时可能遇到的常见错误或陷阱。​

  1. 忘记 await。
  2. 在非 async 函数内部使用 await。
  3. 在循环中不正确地使用 await 导致不必要的顺序执行。
  4. 未处理的异步错误。

如何避免“忘记 await”的问题?​

使用 TypeScript 或 ESLint,它们可以检测这种常见错误。


7. 实际应用​

这通常涉及将给定代码片段转换为使用 async/await 或 Promises。这要根据具体的代码片段来决定。


8. 浏览器和 Node.js 支持​

哪些版本的 Node.js 和浏览器开始支持 async/await?​

Node.js 从 7.6.0 版本开始支持 async/await。大多数现代浏览器都支持它,但旧版本的浏览器可能不支持。

在不支持 async/await 的环境中,如何使用它?​

你可以使用 Babel 或 TypeScript 这样的转译器将 async/await 转换为 ES5 或 ES6 JavaScript。


9. 性能和最佳实践​

async/await 是否比纯 Promises 更慢?​

在大多数情况下,性能差异是可以忽略的。但 async/await 可能会带来一些额外的运行时开销。

何时应该使用 async/await,何时应该使用 Promises?​

  1. 当你需要更简洁和可读的代码时,使用 async/await。
  2. 对于复杂的异步逻辑或需要更细粒度控制的场景,使用 Promises。

10. 其他特性和提议​

对于 async iterators 和 for-await-of 的了解。​

  1. async iterators 是一种可以异步生成值的迭代器。
  2. for-await-of 是一种循环结构,允许你等待 async iterator 的每个值。

了解其他与 async/await 相关的 ES 提议,如顶级 await。​

顶级 await 是一个提议,允许你在模块的顶级使用 await,而不是仅在 async 函数中。

JavaScript事件环宏任务和微任务

· 阅读需 1 分钟
素明诚
Full stack development

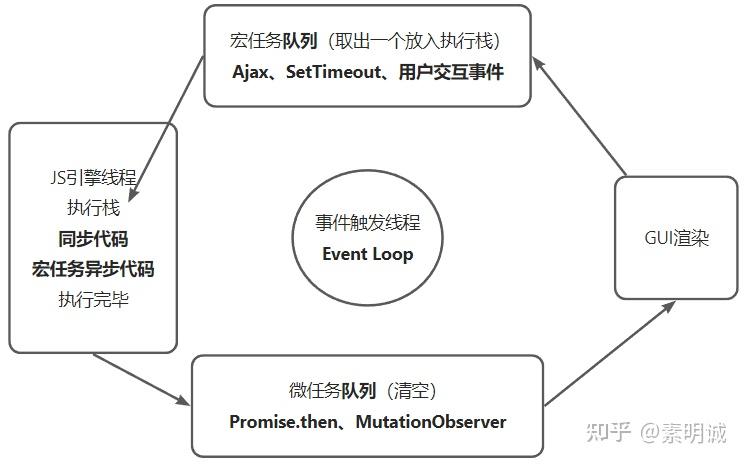
JavaScript 是单线程语言,它在一个事件环中处理所有任务。事件环是一个循环,在每一轮中,JavaScript 引擎会处理所有排队的任务,包括计算、事件处理以及其他任务。

在 JavaScript 中,任务可以分为两种:宏任务和微任务。

639f1f477d84ad86767cd703ac0b5fd1

宏任务指的是任务队列中的主任务,主要包括:

  • 整体代码(script)
  • 显式的定时器(setTimeout,setInterval)
  • UI 交互事件(click)
  • 网络请求事件

微任务指的是任务队列中的次要任务,主要包括:

  • process.nextTick()
  • Promise
  • Object.observe
  • MutationObserver

JavaScript 引擎在处理完一轮宏任务后,再处理当前微任务队列中的所有任务,直到当前微任务队列中的所有任务都处理完成,再回到主线程,处理下一轮宏任务。这样的循环继续进行,直到所有任务都处理完成。

伪元素和伪类的区别

· 阅读需 2 分钟
素明诚
Full stack development

1. 伪元素 (Pseudo-elements)​

  • 定义: 伪元素允许你为某一部分的元素设置样式,如选择元素的某一部分或在元素的内容前后插入内容。
  • 语法: 在 CSS3 中,伪元素使用双冒号 :: 前缀,例如 ::before 和 ::after。
  • 常见伪元素: ::before, ::after, ::first-line, ::first-letter, ::selection。
  • 用途: 主要用于插入内容和为元素的某一部分设置样式。

2. 伪类 (Pseudo-classes)​

  • 定义: 伪类允许你基于元素的特定状态(如悬停或被点击)或其与其他元素的关系来应用样式。
  • 语法: 伪类使用单冒号 : 前缀,例如 :hover 和 :active。
  • 常见伪类: :hover, :active, :focus, :first-child, :last-child, :nth-child(), :not(), :checked 等。
  • 用途: 主要用于描述元素的特定状态或其与其他元素的关系。

主要区别:​

  1. 目的: 伪元素主要用于插入和修改元素的部分内容,而伪类则用于描述元素的状态或与其他元素的关系。
  2. 语法: 在 CSS3 中,伪元素使用双冒号 ::,而伪类使用单冒号 :。
  3. 应用数量: 一个元素可以同时应用多个伪类,但只能应用一个伪元素(例如,你不能同时应用 ::before 和 ::after 于同一元素上,但可以应用 :hover 和 :active)。

个人觉得,伪元素应该叫辅助元素,伪类应该叫状态元素更贴切

递归 和 Memorization

· 阅读需 2 分钟
素明诚
Full stack development

为什么要在递归中使用记忆化:

  1. 避免重复计算:许多递归问题的子问题是重复的,这意味着在递归过程中会多次计算相同的子问题。通过存储这些子问题的结果并在需要时检索它们,可以避免这种重复计算,从而节省时间。
  2. 减少递归深度:对于某些问题,使用记忆化可以减少递归调用的数量和深度,从而避免栈溢出。
  3. 转换为动态规划:记忆化是将递归算法转换为动态规划算法的一个常见步骤。动态规划是一种特殊的递归,其中每个子问题只解决一次,并将其结果存储在一个表格中,以便后续使用。

下面是一个简单的例子:斐波那契数列。原始的递归解决方案会有很多重复的计算,但使用记忆化可以避免这些重复。

1. 不使用记忆化的递归方法:​

function fibonacci(n) {
if (n <= 1) return n;
return fibonacci(n - 1) + fibonacci(n - 2);
}

这个方法的问题是,对于较大的 n,它会进行大量的重复计算。

2. 使用记忆化的递归方法:​

为了实现记忆化,我们需要一个数据结构(通常是一个数组或对象)来存储已经计算过的子问题的解。

function fibonacciWithMemo(n, memo = {}) {
// 如果已经计算过这个值,直接从 memo 中返回
if (n in memo) return memo[n];

// 基础情况
if (n <= 1) return n;

// 递归计算并将结果存储到 memo 中
memo[n] = fibonacciWithMemo(n - 1, memo) + fibonacciWithMemo(n - 2, memo);

return memo[n];
}

在这个版本中,使用一个名为 memo 的对象来存储已经计算过的斐波那契数。当函数再次被调用时,它首先检查 memo 对象中是否已经有了该数的值。如果有,则直接返回这个值,从而避免了不必要的重复计算。