跳到主要内容

91 篇博文 含有标签「后端」

后端开发技术文章

查看所有标签

Go 中的 atomic 的使用场景

· 阅读需 4 分钟
素明诚
Full stack development

atomic 的最佳实践和使用场景​

计数器和统计信息​

原子包常用于实现高性能的计数器或统计数据收集,例如计算网站访问量、服务调用次数等。因为这些操作通常涉及单个变量的简单增减,使用原子操作比引入互斥锁更为高效。

var visitors int64
// 每次用户访问时,增加访客数量
atomic.AddInt64(&visitors, 1)

状态标志管理​

在多线程环境中,使用原子操作来检查或设置状态标志可以避免使用锁,特别是在状态变化不频繁,但检查频繁的场景。

var state int32
// 设置状态
atomic.StoreInt32(&state, 1)
// 检查状态
if atomic.LoadInt32(&state) == 1 {
// 执行某些操作
}

无锁数据结构​

在实现无锁数据结构,如无锁队列、无锁栈等时,原子操作是必不可少的工具。这些数据结构通常用在高性能或实时系统中,可以显著减少线程阻塞。

type AtomicInt struct {
value int64
}
​
func (a *AtomicInt) Increment() {
atomic.AddInt64(&a.value, 1)
}
​
func (a *AtomicInt) Get() int64 {
return atomic.LoadInt64(&a.value)
}

不建议使用的场景​

复杂状态或多变量协同​

当操作涉及到多个变量或者状态较为复杂的同步时,仅使用原子操作往往无法有效管理。例如,需要根据多个变量的值决定逻辑流程的情况,使用互斥锁可能是更好的选择,因为它们可以同时保护多个变量。

// 错误用法:尝试使用原子操作同步多个变量
var a, b int32
atomic.AddInt32(&a, 1)
atomic.AddInt32(&b, 1)
// 无法保证 a 和 b 的增加操作是同步发生的

复杂的业务逻辑​

如果业务逻辑需要条件同步,涉及多步骤验证或者复合状态变化,使用原子操作会使代码复杂且难以维护。在这些场景中,使用更高级的同步机制(如通道、锁或条件变量等)通常更加合适。

高频度的写操作​

原子操作确保了单个操作的原子性,即在操作过程中不会被其他线程打断。这通过硬件级别的支持完成,通常是通过一种称为“比较并交换”(Compare-and-Swap, CAS)的操作。当你有多个线程试图同时修改同一个变量时,每个线程都会尝试执行 CAS 操作:

  1. 读取当前值:线程首先读取目标变量的当前值。
  2. 计算新值:基于当前值,线程计算新的值。
  3. 比较并交换:如果目标变量的当前值与步骤 1 中读到的值相同,CAS 操作会将新值写入变量。如果不同,说明在此期间内其他线程已经修改了变量,当前线程的操作失败,通常会重试。

频繁的写操作引发的问题

当大量线程频繁尝试更新同一个变量时,以下问题可能发生

  • 争用高:每个线程都尝试修改数据,但由于 CAS 的工作机制,只有一个线程的修改能成功,其他线程需要重试。这导致了高争用,多个线程不断重试,浪费 CPU 资源。
  • 性能瓶颈:尽管原子操作比锁的开销小,但当争用非常激烈时,线程频繁进行无效的重试,这会成为系统性能的瓶颈。
  • 线程饥饿:在极端的争用场景中,某些线程可能会长时间地成功不了操作,导致线程饥饿。

所以在确保线程安全的同时,优化系统的整体性能,避免因原子操作的过度使用而导致的性能瓶颈。atomic 包在处理简单的同步需求时非常有用,尤其适合于轻量级的操作,比如状态标志或计数器。
云计算领域的 IaaSPaaSSaaSCaaSFaaSDBaaS 是什么

· 阅读需 4 分钟
素明诚
Full stack development

IaaS:智能基础设施即服务的未来(Infrastructure as a Service)​

IaaS,作为提供虚拟化计算资源的服务模型,涵盖了服务器、存储和网络。这种模式让企业可以按需购买、使用计算资源,避免了高昂的硬件投资和维护成本。技术上,IaaS 使用虚拟化技术保证了不同用户资源的安全隔离,确保了服务的高效运行。云服务提供商通过计算资源使用量获得收益。Amazon EC2、Microsoft Azure Virtual Machines 和阿里云的 ECS 是此模型的杰出代表。例如,Netflix 利用 AWS 的 EC2 支撑其全球流媒体业务,通过动态调整资源,优化了成本。

PaaS:全方位平台即服务模型(Platform as a Service)​

PaaS 提供了包含开发、测试、部署、运行和管理应用的完整平台。开发者可以专注于代码编写和业务逻辑实现,而无需管理底层硬件和操作系统。PaaS 解决了企业自建开发环境的时间和成本问题,通常采用订阅或按使用量付费的盈利模式。Heroku 和 Google App Engine 是优秀的 PaaS 产品,而百度云的 BAE 和华为云的 AppEngine 也提供了相应服务。Slack 利用 Heroku 在初创阶段快速开发和部署其聊天应用,缩短了产品上市时间。滴滴出行也曾使用类似的 PaaS 平台快速迭代和部署其服务。

SaaS:便捷高效的软件即服务应用(Software as a Service)​

SaaS 提供了互联网上可直接使用的软件应用,免除了用户的安装和维护需求。这些应用通常采用云端架构、多租户模式和自动化部署技术,保证了软件的高可用性和灵活性。Salesforce 和 Office 365 是典型的 SaaS 应用,分别提供在线 CRM 系统和办公软件。钉钉和腾讯文档在中国提供企业通讯和文档协作的 SaaS 解决方案。Dropbox 和 Zoom 为用户提供在线存储和视频会议服务,展示了 SaaS 模型解决软件安装、维护和升级复杂性的优势。

CaaS:针对微服务架构的容器即服务模型(Container as a Service)​

CaaS 为容器化应用的部署和管理提供了环境,特别适合于微服务架构的应用。这种模型简化了服务的部署、扩展和管理过程。Google Kubernetes Engine 和 Amazon EKS 提供了全面的容器编排和管理解决方案,而阿里云的 ACK 为开发者提供了强大的容器管理能力。例如,Spotify 使用 Google Kubernetes Engine 管理其庞大的微服务架构,实现了服务的高效扩展和故障恢复。

FaaS:无服务器计算的函数即服务框架(Function as a Service)​

FaaS 提供了一个事件驱动的无服务器计算框架,使开发者能够编写由事件触发的短小业务逻辑函数,而无需关心底层服务器的管理。AWS Lambda 和 Azure Functions 允许用户编写函数响应各种事件,而阿里云的函数计算 FC 也提供了类似的执行环境。这些函数处理如图片上传后的自动缩放和优化,解决了服务器资源浪费和复杂扩展问题。

DBaaS:灵活高效的数据库即服务模型(Database as a Service)​

DBaaS 提供了完整的数据库服务,用户无需关心底层硬件和数据库软件的维护。Amazon RDS 和 Azure SQL Database 允许用户快速部署和管理数据库,同时提供备份、恢复和扩展功能。腾讯云的云数据库 MySQL 在中国提供高效的数据库服务。电子商务网站利用 Amazon RDS 存储订单和用户信息,享受了高可用性和灵活扩展的优势。

Go 语言中的锁类型与应用场景详解

· 阅读需 3 分钟
素明诚
Full stack development

常用的锁的类型​

锁类型描述用途
Mutex互斥锁,一次只允许一个 goroutine 访问某个资源。用于保护共享资源,避免并发写入时出现数据竞争。
RWMutex读写锁,允许多个读操作同时进行,但写操作是互斥的。适用于读多写少的场景,可以提高在频繁读取时的性能。
Once一次性锁,确保某个操作在全局范围内只被执行一次。主要用于资源的初始化,如单例模式的实现中保证只初始化一次。
Cond条件变量,用于等待或宣布事件的发生。当 goroutine 需要等待某个条件满足时使用,常与 Mutex 或 RWMutex 配合使用。

RWMutex vs. Mutex​

Mutex(互斥锁)​

  • 功能:提供基本的锁定功能,确保同一时刻只有一个 goroutine 可以访问资源。
  • 适用场景:适用于对数据进行频繁写操作的场景。

RWMutex(读写锁)​

  • 优势:允许多个读取操作同时进行,而写操作则需独占资源。
  • 性能优化:在读多写少的应用场景中,RWMutex 比 Mutex 更高效,因为它减少了读操作的等待时间。

代码示例​

Mutex(互斥锁)​

package main
​
import (
"fmt"
"sync"
)
​
var mutex sync.Mutex
var balance int
​
func Deposit(amount int) {
defer mutex.Unlock()
mutex.Lock()
balance += amount
}
​
func Balance() int {
defer mutex.Unlock()
mutex.Lock()
return balance
}
​
func main() {
Deposit(100)
fmt.Println("Current Balance:", Balance())
}
​

RWMutex(读写锁)​

package main
​
import (
"fmt"
"sync"
)
​
var rwMutex sync.RWMutex
var data2 int
var wg sync.WaitGroup
​
func ReadData(id int) {
defer rwMutex.RUnlock()
rwMutex.RLock()
fmt.Printf("Goroutine %d read data: %d\n", id, data2)
​
wg.Done()
}
​
func WriteData(id, d int) {
defer rwMutex.Unlock()
rwMutex.Lock()
data2 = d
fmt.Printf("Goroutine %d write data: %d\n", id, d)
wg.Done()
}
​
func main() {
// 启动多个读写goroutines
numGoroutines := 10
wg.Add(numGoroutines * 2) // 因为有numGoroutines个读goroutine和numGoroutines个写goroutine
​
for i := 0; i < numGoroutines; i++ {
go WriteData(i, i*10) // 每个goroutine写入不同的数据
go ReadData(i) // 同时进行读操作
}
​
wg.Wait() // 等待所有goroutine完成
fmt.Println("Final Data:", data2)
}
​

Once(一次性锁)​

package main
​
import (
"fmt"
"sync"
)
​
var once sync.Once
var value int
​
func Setup() {
value = 42
fmt.Println("Value set")
}
​
func DoSetup() {
once.Do(Setup)
}
​
func main() {
go DoSetup()
go DoSetup()
go DoSetup()
​
// WaitGroup 等待 goroutines 完成
var wg sync.WaitGroup
wg.Add(3)
go func() {
defer wg.Done()
DoSetup()
}()
go func() {
defer wg.Done()
DoSetup()
}()
go func() {
defer wg.Done()
DoSetup()
}()
wg.Wait()
fmt.Println("value:", value)
}

Cond(条件变量)​

package main
​
import (
"sync"
"time"
)
​
var cond = sync.NewCond(&sync.Mutex{})
var ready bool
var wg4 sync.WaitGroup
​
// process 处理特定的进程,等待条件变量通知
func process(i int) {
defer wg4.Done()
defer cond.L.Unlock()
cond.L.Lock()
for !ready {
cond.Wait()
}
println("进程", i, "已准备就绪")
}
​
func main() {
for i := 0; i < 5; i++ {
wg4.Add(1)
go process(i)
}
println("所有协程已创建")
​
time.Sleep(2 * time.Second) // 确保所有子协程都进入等待状态
​
cond.L.Lock()
ready = true
cond.Broadcast()
cond.L.Unlock()
​
wg4.Wait() // 等待所有子协程完成
}
​

Go 盐值加密和密码生成

· 阅读需 4 分钟
素明诚
Full stack development

盐值加密是一种安全策略,用于增强存储在数据库中的密码的安全性。在这个过程中,每个密码都会随机添加一个数据片段,即“盐”,这样即使两个用户使用相同的密码,它们存储在数据库中的形式也会不同。这种方法可以有效地抵抗彩虹表攻击等密码攻击技术。我尽可能的用最简短的话讲明白这个流程。

流程详解​

首次设定密码时的操作

  • 用户设置密码。
  • 系统生成一个随机的盐值。
  • 系统将这个盐值和用户的密码合并后,通过哈希函数生成哈希值。
  • 将生成的盐值和哈希值一起存储在数据库中(通常是同一字段,例如在 bcrypt 中,盐和哈希值是一起编码在一个字符串中)。

用户登录时的操作

  • 用户输入密码。
  • 系统从数据库中取出含盐的哈希值。
  • 系统从存储的哈希值中解析出盐值(对于 bcrypt 等库,这一步是自动完成的)。
  • 系统使用提取出的盐值和用户输入的密码重新进行哈希操作。
  • 系统比较这个新生成的哈希值和数据库中存储的哈希值,如果相同,则验证成功;如果不同,则密码错误。

关键点​

  • 盐的重用:验证密码时使用的盐是第一次生成并存储的盐,不是每次都重新生成的。这保证了只要输入的密码正确,无论验证多少次,生成的哈希值总是一致的。
  • 存储方式:在像 bcrypt 这样的现代密码哈希库中,盐值是自动与哈希值一起生成和存储的。你不需要手动处理盐的存储和提取,库会为你管理这些细节。

Go 语言实现盐值加密的示例​

以下是一个使用 Go 语言和golang.org/x/crypto/bcrypt库来实现盐值哈希的示例。这个库自动处理盐的生成和存储。

package main
​
import (
"fmt"
"golang.org/x/crypto/bcrypt"
)
​
// GenerateHash 使用bcrypt生成盐值哈希
func GenerateHash(password string) (string, error) {
// GenerateFromPassword 自动添加盐并生成哈希
hashedPassword, err := bcrypt.GenerateFromPassword([]byte(password), bcrypt.DefaultCost)
if err != nil {
return "", err
}
return string(hashedPassword), nil
}
​
// ComparePasswords 比较用户输入的密码和数据库中的哈希
func ComparePasswords(hashedPwd string, plainPwd string) bool {
// CompareHashAndPassword 比较哈希和密码
err := bcrypt.CompareHashAndPassword([]byte(hashedPwd), []byte(plainPwd))
return err == nil
}
​
func main() {
// 用户设置的密码
password := "securepassword123"
​
// 生成哈希
hashedPassword, err := GenerateHash(password)
if err != nil {
fmt.Println("Error hashing password:", err)
return
}
fmt.Println("Hashed Password:", hashedPassword)
​
// 验证密码
match := ComparePasswords(hashedPassword, "securepassword123")
fmt.Println("Password match:", match)
}

使用bcrypt.GenerateFromPassword生成一个盐值哈希。这个函数自动为每个密码生成一个随机盐,并将盐和哈希存储在同一个字符串中。当需要验证密码时,使用bcrypt.CompareHashAndPassword可以自动处理盐的提取和比对过程。这使得实现更加简单且安全。

需要注意的点​

合适的哈希算法​

  • 安全性:选择已经经过广泛验证且被认为是安全的哈希函数,如bcrypt、scrypt或Argon2,而不是快速的哈希函数如 MD5 或 SHA-1,因为它们容易受到快速暴力攻击。
  • 更新性:随着计算能力的提升,一些原本认为安全的算法可能变得不再安全,因此需要持续关注和更新所使用的算法。

盐的唯一性和随机性​

  • 随机性:盐应该是完全随机生成的,以确保每个哈希都是唯一的,即使是对于相同的密码。
  • 唯一性:为每个密码实例使用不同的盐,即使是同一个用户的密码更新,也应重新生成新的盐。

存储安全​

  • 分离存储:虽然盐值需要和哈希值一起存储,但应确保这些信息的存储方式足够安全,例如使用加密的数据库或安全的存储解决方案。
  • 访问控制:确保只有必要的应用程序和人员能访问存储密码的数据库。

性能考虑​

  • 处理时间:bcrypt和类似的算法设计时就考虑到了耗时较长,以阻碍暴力破解攻击。但这也意味着在实际应用中可能需要考虑到算法对性能的影响。
  • 负载调整:可以通过调整算法的工作因子来平衡安全性和性能需求,如bcrypt的cost参数。

Go 自动解引用

· 阅读需 2 分钟
素明诚
Full stack development

访问数组或切片元素​

当你拥有一个指向数组或切片的指针时,可以直接使用索引访问其元素,而无需手动解引用。

arr := [3]int{10, 20, 30}
pArr := &arr
fmt.Println(pArr[1]) // 输出 20,编译器自动处理了 (*pArr)[1]

访问结构体字段​

指向结构体的指针,可以直接访问该结构体的任何字段,就像你在操作结构体实例一样

type Person struct {
Name string
Age int
}
​
p := &Person{"Alice", 30}
fmt.Println(p.Name) // 输出 "Alice",编译器自动处理了 (*p).Name

调用方法​

type Person struct {
Name string
Age int
}
​
func (p *Person) Greet() {
fmt.Println("Hello,", p.Name)
}
​
func main() {
person := Person{"Bob", 25}
p := &person
person.Greet() // 可以直接调用
p.Greet() // 同样可以直接调用,Go自动处理了 (*p).Greet()
}

在这个例子中,不论是结构体实例还是其指针,Greet 方法都可以被调用,Go 语言运行时会自动调整。

注意​

  • 在函数参数传递时,Go 中的所有参数都是按值传递的。这意味着如果你将一个结构体传递给函数,它会被复制。但是如果使用指针,则原始数据可以被函数修改。
  • Go 不支持像 C++那样的指针操作。如果你需要进行类似操作,通常可以使用切片或索引进行。

摘要加密对称加密和非对称加密

· 阅读需 4 分钟
素明诚
Full stack development

摘要加密(Hash Encryption)​

摘要加密,通常称为哈希函数(Hash Function),是一种将任意长度的数据转换为固定长度的字符串的过程。哈希函数的结果称为哈希值或消息摘要。

主要特点​

  • 不可逆 ,一旦数据被哈希,原始数据无法通过哈希值逆推出。
  • 定长输出 ,不论输入数据长度如何,输出的哈希值长度是固定的。
  • 高效计算 ,哈希计算速度快,适合大规模数据处理。
  • 抗碰撞 ,两个不同的输入数据不应该产生相同的哈希值(碰撞)。

常用算法​

  • MD5 ,128 位输出,已被认为不安全。
  • SHA-1 ,160 位输出,已被逐步淘汰。
  • SHA-256 ,256 位输出,属于 SHA-2 家族,目前被广泛使用。

应用场景​

  • 数据完整性验证 ,验证数据在传输过程中是否被篡改。
  • 数字签名 ,生成数据的唯一摘要,以证明数据的完整性和来源。
  • 密码存储 ,将密码哈希后存储,避免明文存储密码的安全风险。
import hashlib
​
# 计算字符串的SHA-256哈希值
data = "Hello, World!"
hash_object = hashlib.sha256(data.encode())
hash_value = hash_object.hexdigest()
​
print(f"哈希值: {hash_value}")

对称加密(Symmetric Encryption)​

对称加密是一种加密方式,使用相同的密钥进行加密和解密。

主要特点​

  • 单密钥 ,加密和解密使用相同的密钥。
  • 速度快 ,适合大数据量的加密。

常用算法​

  • AES(高级加密标准)
  • DES(数据加密标准,已被淘汰)
  • 3DES(三重数据加密标准)

应用场景​

  • 数据传输加密 ,如 HTTPS 中的数据加密。
  • 文件加密 ,用于保护存储的文件数据。
from Crypto.Cipher import AES
from Crypto.Random import get_random_bytes
​
# 生成密钥和数据
key = get_random_bytes(16)
data = b"Secret Data"
​
# 创建加密对象并加密数据
cipher = AES.new(key, AES.MODE_EAX)
nonce = cipher.nonce
ciphertext, tag = cipher.encrypt_and_digest(data)
​
print(f"加密数据: {ciphertext}")
​
# 创建解密对象并解密数据
cipher_decrypt = AES.new(key, AES.MODE_EAX, nonce=nonce)
decrypted_data = cipher_decrypt.decrypt(ciphertext)
​
print(f"解密数据: {decrypted_data}")

非对称加密(Asymmetric Encryption)​

非对称加密使用一对密钥 ,公钥(public key)和私钥(private key)。公钥用于加密,私钥用于解密。

主要特点​

  • 双密钥 ,加密和解密使用不同的密钥。
  • 计算较慢 ,相较对称加密,计算速度较慢,适合少量数据的加密。

常用算法​

  • RSA(Rivest-Shamir-Adleman)
  • ECC(椭圆曲线加密)

应用场景​

  • 密钥交换 ,用于交换对称加密的密钥。
  • 数字签名 ,用于验证发送者身份和数据完整性。
  • 安全电子邮件 ,如 PGP(Pretty Good Privacy)。
from Crypto.PublicKey import RSA
from Crypto.Cipher import PKCS1_OAEP
​
# 生成公钥和私钥
key = RSA.generate(2048)
public_key = key.publickey()
private_key = key
​
# 数据加密
cipher_rsa = PKCS1_OAEP.new(public_key)
data = b"Confidential Data"
ciphertext = cipher_rsa.encrypt(data)
​
print(f"加密数据: {ciphertext}")
​
# 数据解密
cipher_rsa_decrypt = PKCS1_OAEP.new(private_key)
decrypted_data = cipher_rsa_decrypt.decrypt(ciphertext)
​
print(f"解密数据: {decrypted_data}")

比较​

特性摘要加密对称加密非对称加密
密钥无密钥单密钥公钥和私钥
方向单向双向双向
用途数据完整性验证、密码存储大数据量传输加密、文件加密密钥交换、数字签名、安全通讯
速度快快慢
安全性抗碰撞能力有限依赖密钥的保密性基于数学难题,安全性高
算法MD5, SHA-1, SHA-256AES, DES, 3DESRSA, ECC

总结​

  • 摘要加密 ,主要用于数据完整性验证,不能还原原始数据。
  • 对称加密 ,适合快速、大量数据的加密与解密,但需要安全管理密钥。
  • 非对称加密 ,适合安全的密钥交换和数字签名,计算复杂度较高,适合少量数据的加密。

Go 中的 nil 和零值

· 阅读需 1 分钟
素明诚
Full stack development

nil 的作用和适用类型​

Go 语言中,nil 是特定类型的零值,主要用于表示引用类型的未初始化状态

类型说明
指针指向 nil 表示没有指向任何对象。
切片切片为 nil 表示它没有分配任何底层数组。
映射映射为 nil 表示它没有分配内存空间。
通道通道为 nil 表示它未被初始化。
函数函数为 nil 表示没有关联的实现代码。
接口接口为 nil 表示它没有指向任何实现该接口的值。

基本数据类型的零值​

与引用类型不同,基本数据类型和结构体的零值是按类型直接初始化的具体值,并不使用 nil

类型零值
整数 (int)0
浮点数 (float64)0.0
布尔 (bool)false
字符串 (string)"" (空字符串)
结构体 (struct)结构体中的每个字段都被初始化为其类型的零值

Go 常量的设计与优势

· 阅读需 2 分钟
素明诚
Full stack development

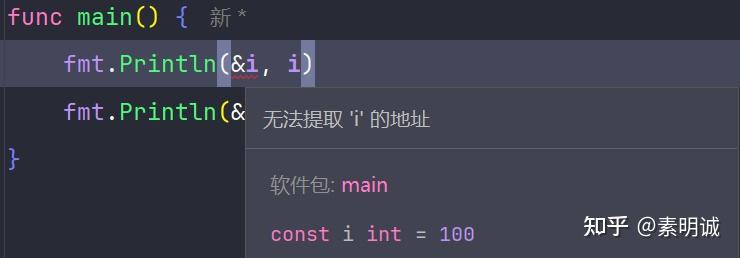
看下面这段代码​

package main
​
import "fmt"
​
const i = 100
​
var j = 123
​
func main() {
fmt.Println(&i, i)
fmt.Println(&j, j)
}

无法获取到I的地址

d92293b286b371adfffbd998de2f064e

在 Go 语言中,常量和变量是以不同的方式处理的,这种设计有其独特的理由和优势。常量在 Go 中被定义为在编译时就已知且不可变的值,它们不占用运行时的内存地址。这一设计是出于以下几个考虑

简化语义​

常量的不可变性是其核心特性。Go 语言通过不允许获取常量的地址,确保常量一旦被定义,其值就不能被改变。这避免了常量值可能的修改,维持了常量“永恒不变”的语义,从而简化了常量的使用和理解。

编译器优化​

由于常量的值在编译期已确定,编译器可以将常量值直接内联到使用它们的代码中。这样的优化减少了运行时的内存访问,提高了代码的执行效率。

减少运行时开销​

如果常量占用内存地址,那么访问常量就需要内存读取操作。Go 通过将常量直接内联到它们被使用的地方,避免了这种开销,使程序运行更高效。

避免意外的指针操作​

不允许获取常量的地址也意味着无法通过指针操作修改常量的值。这防止了程序中的非预期行为,增强了程序的稳定性和安全性。

理解 Go 模块系统依赖管理和常用标记

· 阅读需 2 分钟
素明诚
Full stack development

直接依赖与间接依赖​

直接依赖:这些是项目中明确导入并直接使用的库。在go.mod文件中,这些库列在require块中,无需任何特殊标记。

require google.golang.org/grpc v1.63.2

间接依赖:这些依赖并非直接由项目代码导入,而是由其他库引入的。这些依赖对于项目来说是隐藏的,但它们是必不可少的。在go.mod中,这些依赖后面会添加// indirect标记,以表明它们的间接性。

require github.com/go-sql-driver/mysql v1.7.0 // indirect

go.mod 中的常用标记和指令​

在处理依赖时,go.mod文件提供了几个有用的标记和指令,这些功能使得版本控制更加灵活和可控:

// indirect:此标记指示某个库是间接依赖,即由其他库引入。

// replace : 指令允许开发者指定依赖的替代源,这在调试或替换具有问题的库版本时非常有用。
replace github.com/old/module v1.2.3 => github.com/new/module v1.2.3

// exclude : 指令可以明确排除特定版本的依赖,这对于避免已知缺陷的版本特别有价值。
exclude google.golang.org/grpc v1.29.1

// retract:从Go 1.16开始,retract 指令用于标记模块版本为撤回,以防止其被其他项目使用。

模块管理的实际应用​

在实际开发过程中,合理利用这些标记和指令可以极大地提高依赖管理的效率和安全性。当我们发现某个依赖库的最新版本不稳定或与项目不兼容时,可以通过replace或exclude指令临时替换或排除该版本,而不会影响整个项目的开发和部署。

解决 Go 中结构体成员不能修改的问题的两种方法

· 阅读需 3 分钟
素明诚
Full stack development

map 引用类型的问题​

在 Go 中,如果结构体的成员包含引用类型(如切片、map 或指针),当将该结构体作为 map 的值时,需要注意一些细节。具体来说,如果结构体的成员是引用类型,那么在获取结构体值并修改其引用类型成员时,会遇到不能修改的问题。

package main
​
import "fmt"
​
type Person struct {
name string
age int
}
​
func main() {
m := make(map[string]Person)
​
// 添加键值对
m["john"] = Person{"John", 30}
​
// 获取 john 对应的 Person 结构体值
john := m["john"]
​
// 修改 john 的 age 字段
john.age = 40
​
// 此时输出 map 中 "john" 对应的 age 字段值
fmt.Println(m["john"].age) // 输出 30,而不是 40
}
​

我们创建了一个 Person 结构体类型,并将其作为值存储在了一个 map 中。然后,我们从 map 中取出了键为 "john" 的 Person 结构体值,并尝试修改其 age 字段的值。但是,即使我们修改了 john 的 age 字段,最终打印出来的结果仍然是原来 map 中的值,即 30,而不是修改后的 40。这是因为在 Go 中,m["john"] 返回的是 Person 结构体的值的副本,而不是原始值的引用。因此,修改 john 并不会影响原始值在 map 中的值

如何修改呢?​

第一种方式​

可以通过使用指针类型来存储结构体值,或者在获取结构体值时使用指针,并且修改成员时也要通过指针来操作。

package main
​
import "fmt"
​
type Person struct {
name string
age int
}
​
func main() {
m := make(map[string]*Person)
​
// 添加键值对,值为 Person 结构体的指针
m["john"] = &Person{"John", 30}
​
// 获取 john 对应的 Person 结构体指针
john := m["john"]
​
// 修改 john 指向的结构体的 age 字段
john.age = 40
​
// 此时输出 map 中 "john" 对应的 age 字段值
fmt.Println(m["john"].age) // 输出 40
}
​

我们将 map 中的值类型指定为 *Person,即 Person 结构体的指针。当我们获取键为 "john" 的值时,会得到 Person 结构体的指针,然后可以通过指针来修改结构体的字段。

第二种​

package main
​
import "fmt"
​
type Person struct {
name string
age int
}
​
func main() {
m := make(map[string]Person)
​
// 添加键值对
m["john"] = Person{"John", 30}
​
// 获取 john 对应的 Person 结构体值的指针
john := &m["john"]
​
// 修改 john 指向的结构体的 age 字段
john.age = 40
​
// 此时输出 map 中 "john" 对应的 age 字段值
fmt.Println(m["john"].age) // 输出 40
}
​

先获取了键为 "john" 的 Person 结构体值的指针,并将其赋给 john 变量。然后,通过指针来修改 john 指向的结构体的字段。

使用建议​

建议使用第一种方式,使用指针可以避免复制结构体值,提高效率,并且可以确保所有修改都是针对同一个结构体值的引用,避免了值的复制和不一致的状态。另外,使用指针还可以避免因为值复制而导致的内存占用过多的问题,尤其是在处理大型结构体时更为明显。