跳到主要内容

摘要加密对称加密和非对称加密

· 阅读需 4 分钟
素明诚
Full stack development

摘要加密(Hash Encryption)​

摘要加密,通常称为哈希函数(Hash Function),是一种将任意长度的数据转换为固定长度的字符串的过程。哈希函数的结果称为哈希值或消息摘要。

主要特点​

  • 不可逆 ,一旦数据被哈希,原始数据无法通过哈希值逆推出。
  • 定长输出 ,不论输入数据长度如何,输出的哈希值长度是固定的。
  • 高效计算 ,哈希计算速度快,适合大规模数据处理。
  • 抗碰撞 ,两个不同的输入数据不应该产生相同的哈希值(碰撞)。

常用算法​

  • MD5 ,128 位输出,已被认为不安全。
  • SHA-1 ,160 位输出,已被逐步淘汰。
  • SHA-256 ,256 位输出,属于 SHA-2 家族,目前被广泛使用。

应用场景​

  • 数据完整性验证 ,验证数据在传输过程中是否被篡改。
  • 数字签名 ,生成数据的唯一摘要,以证明数据的完整性和来源。
  • 密码存储 ,将密码哈希后存储,避免明文存储密码的安全风险。
import hashlib
​
# 计算字符串的SHA-256哈希值
data = "Hello, World!"
hash_object = hashlib.sha256(data.encode())
hash_value = hash_object.hexdigest()
​
print(f"哈希值: {hash_value}")

对称加密(Symmetric Encryption)​

对称加密是一种加密方式,使用相同的密钥进行加密和解密。

主要特点​

  • 单密钥 ,加密和解密使用相同的密钥。
  • 速度快 ,适合大数据量的加密。

常用算法​

  • AES(高级加密标准)
  • DES(数据加密标准,已被淘汰)
  • 3DES(三重数据加密标准)

应用场景​

  • 数据传输加密 ,如 HTTPS 中的数据加密。
  • 文件加密 ,用于保护存储的文件数据。
from Crypto.Cipher import AES
from Crypto.Random import get_random_bytes
​
# 生成密钥和数据
key = get_random_bytes(16)
data = b"Secret Data"
​
# 创建加密对象并加密数据
cipher = AES.new(key, AES.MODE_EAX)
nonce = cipher.nonce
ciphertext, tag = cipher.encrypt_and_digest(data)
​
print(f"加密数据: {ciphertext}")
​
# 创建解密对象并解密数据
cipher_decrypt = AES.new(key, AES.MODE_EAX, nonce=nonce)
decrypted_data = cipher_decrypt.decrypt(ciphertext)
​
print(f"解密数据: {decrypted_data}")

非对称加密(Asymmetric Encryption)​

非对称加密使用一对密钥 ,公钥(public key)和私钥(private key)。公钥用于加密,私钥用于解密。

主要特点​

  • 双密钥 ,加密和解密使用不同的密钥。
  • 计算较慢 ,相较对称加密,计算速度较慢,适合少量数据的加密。

常用算法​

  • RSA(Rivest-Shamir-Adleman)
  • ECC(椭圆曲线加密)

应用场景​

  • 密钥交换 ,用于交换对称加密的密钥。
  • 数字签名 ,用于验证发送者身份和数据完整性。
  • 安全电子邮件 ,如 PGP(Pretty Good Privacy)。
from Crypto.PublicKey import RSA
from Crypto.Cipher import PKCS1_OAEP
​
# 生成公钥和私钥
key = RSA.generate(2048)
public_key = key.publickey()
private_key = key
​
# 数据加密
cipher_rsa = PKCS1_OAEP.new(public_key)
data = b"Confidential Data"
ciphertext = cipher_rsa.encrypt(data)
​
print(f"加密数据: {ciphertext}")
​
# 数据解密
cipher_rsa_decrypt = PKCS1_OAEP.new(private_key)
decrypted_data = cipher_rsa_decrypt.decrypt(ciphertext)
​
print(f"解密数据: {decrypted_data}")

比较​

特性摘要加密对称加密非对称加密
密钥无密钥单密钥公钥和私钥
方向单向双向双向
用途数据完整性验证、密码存储大数据量传输加密、文件加密密钥交换、数字签名、安全通讯
速度快快慢
安全性抗碰撞能力有限依赖密钥的保密性基于数学难题,安全性高
算法MD5, SHA-1, SHA-256AES, DES, 3DESRSA, ECC

总结​

  • 摘要加密 ,主要用于数据完整性验证,不能还原原始数据。
  • 对称加密 ,适合快速、大量数据的加密与解密,但需要安全管理密钥。
  • 非对称加密 ,适合安全的密钥交换和数字签名,计算复杂度较高,适合少量数据的加密。
Go 中的 nil 和零值

· 阅读需 1 分钟
素明诚
Full stack development

nil 的作用和适用类型​

Go 语言中,nil 是特定类型的零值,主要用于表示引用类型的未初始化状态

类型说明
指针指向 nil 表示没有指向任何对象。
切片切片为 nil 表示它没有分配任何底层数组。
映射映射为 nil 表示它没有分配内存空间。
通道通道为 nil 表示它未被初始化。
函数函数为 nil 表示没有关联的实现代码。
接口接口为 nil 表示它没有指向任何实现该接口的值。

基本数据类型的零值​

与引用类型不同,基本数据类型和结构体的零值是按类型直接初始化的具体值,并不使用 nil

类型零值
整数 (int)0
浮点数 (float64)0.0
布尔 (bool)false
字符串 (string)"" (空字符串)
结构体 (struct)结构体中的每个字段都被初始化为其类型的零值

Linux 下目录的用途和功能

· 阅读需 3 分钟
素明诚
Full stack development
目录用途描述
/bin存放基本的系统命令和程序,如 ls、cp 等,这些命令对所有用户都是可用的。
/boot包含启动 Linux 系统所需的文件,如内核和引导加载程序(如 GRUB)。
/dev包含设备文件,这些特殊文件代表或访问系统上的硬件设备。
/etc存放系统配置文件,如系统启动、运行所需的配置脚本和设置。
/home用户的主目录,通常每个用户有一个以用户名命名的目录。
/lib存放系统最基本的动态链接共享库,其功能类似于 Windows 里的 DLL 文件。
/lib32存放 32 位系统的库文件,主要用于在 64 位系统上支持 32 位应用。
/lib64存放 64 位系统的库文件。
/libx32存放用于支持 x32 ABI 的库文件,这种 ABI 允许在 64 位系统上运行 32 位代码。
/lost+found通常用于系统非正常关机后,存放 fsck 检查文件系统时恢复的文件。
/media用于挂载可移动媒体设备,如 CD-ROMs、USB 驱动器等。
/mnt临时挂载文件系统的传统挂载点。
/opt用于存放可选的应用软件包和数据文件。
/proc虚拟文件系统,表示系统内存中的进程信息,以文件系统的方式提供访问。
/root超级用户(系统管理员)的主目录。
/run一个临时文件系统,存放自系统启动以来的信息。如当前登录的用户和运行的服务。
/sbin存放系统管理命令,如用于启动、修复、恢复系统的命令。
/snap用于存放 Snap 应用程序包。
/srv存放一些服务启动之后需要访问的数据。
/swap.img一个文件,被用作交换空间;在某些配置中用文件而非分区作为交换空间。
/sys虚拟文件系统,提供对内核内部数据结构的访问,以及更改内核运行时设置的接口。
/tmp存放临时文件,系统重启时,此目录下的数据通常会被删除。
/usr用户应用程序和文件的存储目录,包含大多数用户安装的软件、库文件、文档等。
/var存放经常变化的文件,如日志文件、邮件队列等。

Go 常量的设计与优势

· 阅读需 2 分钟
素明诚
Full stack development

看下面这段代码​

package main
​
import "fmt"
​
const i = 100
​
var j = 123
​
func main() {
fmt.Println(&i, i)
fmt.Println(&j, j)
}

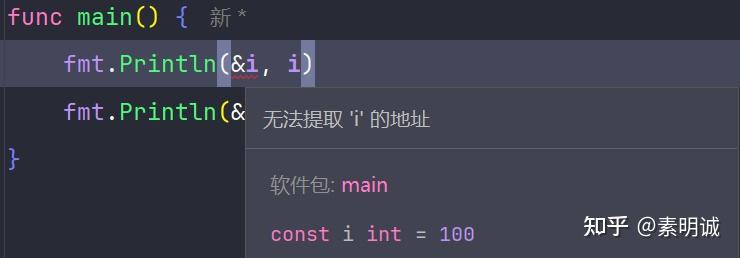
无法获取到I的地址

d92293b286b371adfffbd998de2f064e

在 Go 语言中,常量和变量是以不同的方式处理的,这种设计有其独特的理由和优势。常量在 Go 中被定义为在编译时就已知且不可变的值,它们不占用运行时的内存地址。这一设计是出于以下几个考虑

简化语义​

常量的不可变性是其核心特性。Go 语言通过不允许获取常量的地址,确保常量一旦被定义,其值就不能被改变。这避免了常量值可能的修改,维持了常量“永恒不变”的语义,从而简化了常量的使用和理解。

编译器优化​

由于常量的值在编译期已确定,编译器可以将常量值直接内联到使用它们的代码中。这样的优化减少了运行时的内存访问,提高了代码的执行效率。

减少运行时开销​

如果常量占用内存地址,那么访问常量就需要内存读取操作。Go 通过将常量直接内联到它们被使用的地方,避免了这种开销,使程序运行更高效。

避免意外的指针操作​

不允许获取常量的地址也意味着无法通过指针操作修改常量的值。这防止了程序中的非预期行为,增强了程序的稳定性和安全性。

理解 Go 模块系统依赖管理和常用标记

· 阅读需 2 分钟
素明诚
Full stack development

直接依赖与间接依赖​

直接依赖:这些是项目中明确导入并直接使用的库。在go.mod文件中,这些库列在require块中,无需任何特殊标记。

require google.golang.org/grpc v1.63.2

间接依赖:这些依赖并非直接由项目代码导入,而是由其他库引入的。这些依赖对于项目来说是隐藏的,但它们是必不可少的。在go.mod中,这些依赖后面会添加// indirect标记,以表明它们的间接性。

require github.com/go-sql-driver/mysql v1.7.0 // indirect

go.mod 中的常用标记和指令​

在处理依赖时,go.mod文件提供了几个有用的标记和指令,这些功能使得版本控制更加灵活和可控:

// indirect:此标记指示某个库是间接依赖,即由其他库引入。

// replace : 指令允许开发者指定依赖的替代源,这在调试或替换具有问题的库版本时非常有用。
replace github.com/old/module v1.2.3 => github.com/new/module v1.2.3

// exclude : 指令可以明确排除特定版本的依赖,这对于避免已知缺陷的版本特别有价值。
exclude google.golang.org/grpc v1.29.1

// retract:从Go 1.16开始,retract 指令用于标记模块版本为撤回,以防止其被其他项目使用。

模块管理的实际应用​

在实际开发过程中,合理利用这些标记和指令可以极大地提高依赖管理的效率和安全性。当我们发现某个依赖库的最新版本不稳定或与项目不兼容时,可以通过replace或exclude指令临时替换或排除该版本,而不会影响整个项目的开发和部署。

解决 Go 中结构体成员不能修改的问题的两种方法

· 阅读需 3 分钟
素明诚
Full stack development

map 引用类型的问题​

在 Go 中,如果结构体的成员包含引用类型(如切片、map 或指针),当将该结构体作为 map 的值时,需要注意一些细节。具体来说,如果结构体的成员是引用类型,那么在获取结构体值并修改其引用类型成员时,会遇到不能修改的问题。

package main
​
import "fmt"
​
type Person struct {
name string
age int
}
​
func main() {
m := make(map[string]Person)
​
// 添加键值对
m["john"] = Person{"John", 30}
​
// 获取 john 对应的 Person 结构体值
john := m["john"]
​
// 修改 john 的 age 字段
john.age = 40
​
// 此时输出 map 中 "john" 对应的 age 字段值
fmt.Println(m["john"].age) // 输出 30,而不是 40
}
​

我们创建了一个 Person 结构体类型,并将其作为值存储在了一个 map 中。然后,我们从 map 中取出了键为 "john" 的 Person 结构体值,并尝试修改其 age 字段的值。但是,即使我们修改了 john 的 age 字段,最终打印出来的结果仍然是原来 map 中的值,即 30,而不是修改后的 40。这是因为在 Go 中,m["john"] 返回的是 Person 结构体的值的副本,而不是原始值的引用。因此,修改 john 并不会影响原始值在 map 中的值

如何修改呢?​

第一种方式​

可以通过使用指针类型来存储结构体值,或者在获取结构体值时使用指针,并且修改成员时也要通过指针来操作。

package main
​
import "fmt"
​
type Person struct {
name string
age int
}
​
func main() {
m := make(map[string]*Person)
​
// 添加键值对,值为 Person 结构体的指针
m["john"] = &Person{"John", 30}
​
// 获取 john 对应的 Person 结构体指针
john := m["john"]
​
// 修改 john 指向的结构体的 age 字段
john.age = 40
​
// 此时输出 map 中 "john" 对应的 age 字段值
fmt.Println(m["john"].age) // 输出 40
}
​

我们将 map 中的值类型指定为 *Person,即 Person 结构体的指针。当我们获取键为 "john" 的值时,会得到 Person 结构体的指针,然后可以通过指针来修改结构体的字段。

第二种​

package main
​
import "fmt"
​
type Person struct {
name string
age int
}
​
func main() {
m := make(map[string]Person)
​
// 添加键值对
m["john"] = Person{"John", 30}
​
// 获取 john 对应的 Person 结构体值的指针
john := &m["john"]
​
// 修改 john 指向的结构体的 age 字段
john.age = 40
​
// 此时输出 map 中 "john" 对应的 age 字段值
fmt.Println(m["john"].age) // 输出 40
}
​

先获取了键为 "john" 的 Person 结构体值的指针,并将其赋给 john 变量。然后,通过指针来修改 john 指向的结构体的字段。

使用建议​

建议使用第一种方式,使用指针可以避免复制结构体值,提高效率,并且可以确保所有修改都是针对同一个结构体值的引用,避免了值的复制和不一致的状态。另外,使用指针还可以避免因为值复制而导致的内存占用过多的问题,尤其是在处理大型结构体时更为明显。

Go 切片底层数组的重新分配情况与示例

· 阅读需 2 分钟
素明诚
Full stack development

扩容操作​

当使用 append 向切片追加元素,且追加后的总元素数量超出了切片的原始容量时,Go 会自动重新分配一个更大的底层数组。

slice := []int{1, 2, 3}
slice = append(slice, 4, 5, 6, 7) // 原始容量可能不足以存放所有元素,触发重新分配

从 nil 切片​

从 nil 切片进行 append 对 nil 切片进行 append 操作时,由于 nil 切片没有底层数组,因此会分配一个新的数组。

var slice []int
slice = append(slice, 1) // 从 nil 切片开始,分配新的底层数组

切片截取后再扩容​

如果对一个切片进行截取操作,然后基于这个截取的结果进行 append 操作,并且所需容量超过了截取切片的容量,这同样会触发重新分配。

original := []int{1, 2, 3, 4, 5}
subSlice := original[:2] // 容量仍然是 5
subSlice = append(subSlice, 6, 7, 8, 9, 10, 11) // 容量超载,需要重新分配

显式使用 make 指定初始容量​

当使用 make 创建切片时,可以指定一个初始容量,这种方式创建的切片将拥有独立的底层数组。

slice := make([]int, 0, 10)  // 创建一个初始容量为 10 的空切片

通过 copy 创建新切片​

使用 copy 函数可以创建一个完全独立的切片副本,该副本将拥有自己的底层数组。

original := []int{1, 2, 3}
clone := make([]int, len(original))
copy(clone, original) // clone 现在有了一个完全独立的底层数组

求赞~

Go 命名返回值和非命名返回值在使用 defer 时的不同表现

· 阅读需 2 分钟
素明诚
Full stack development

使用命名返回值​

通过 defer 修改这个返回值。

package main
​
import "fmt"
​
func modifyWithNamedReturn() (result int) {
defer func() {
result += 5 // 修改命名返回值
}()

return 10 // 初始设置返回值为 10
}
​
func main() {
fmt.Println(modifyWithNamedReturn()) // 输出 15
}

解释​

  • 这个函数 modifyWithNamedReturn 中有一个命名返回值 result。
  • 函数返回时,首先设置 result 为 10。
  • 在函数实际返回前,defer 语句执行,将 result 的值增加 5。
  • 因此,虽然 return 语句最初将返回值设置为 10,defer 修改后,最终返回值变为 15。

使用非命名返回值​

defer 如何无法修改返回值。

package main
​
import "fmt"
​
func modifyWithoutNamedReturn() int {
var result int

defer func() {
result += 5 // 尝试修改,但不影响返回值
}()
result = 10 // 设置 result 的值

return result // 返回 result 的值
}
​
func main() {
fmt.Println(modifyWithoutNamedReturn()) // 输出 10
}

解释​

  • 函数 modifyWithoutNamedReturn 返回一个非命名返回值。
  • result 被设置为 10,并准备用作返回值。
  • 尽管 defer 函数将 result 增加了 5,但这种修改发生在返回值被确定(已复制)后,因此对实际返回给调用者的值没有影响。
  • 最终输出为 10,展示了即使 defer 修改了局部变量 result,也不会改变返回值。

defer 使用总结​

defer 在命名返回值情况下可以修改最终的返回值,因为命名返回值的作用域延伸至整个函数,包括 defer 执行的时间。而在非命名返回值的情况下,return 语句实际上是将值复制到返回位置,此后的 defer 修改不再影响已经设置的返回值。

简单点可以这样理解,命名返回值,说明返回值很重要,要都处理完再返回~

Go 语言中的作用域

· 阅读需 2 分钟
素明诚
Full stack development

宇宙块(Universe block)​

宇宙块是 Go 语言中最顶层的作用域,包含了所有内置的类型和函数。

package main
​
import "fmt"
​
func main() {
var num int = len("Hello") // 使用内置函数 len
fmt.Println(num) // 使用内置包 fmt
}

在这个例子中,len 和 fmt 都是宇宙块的一部分,它们在任何 Go 程序中都是可用的。

包块(Package block)​

包块包含了一个包内的所有 Go 源代码文本,其内定义的变量在整个包内可见。

// 文件 1: math.go
package math
​
var Factor int = 2
​
// 文件 2: double.go
package math
​
func Double(n int) int {
return n * Factor // 可以访问同一个包内的其他文件中定义的变量 Factor
}

在这个例子中,Factor 在 math 包的包块中定义,可以在同一个包内的其他文件中使用。

文件块(File block)​

文件块是仅限于单个文件的作用域。

// 文件: util.go
package util
​
var helper = "hidden" // 只在 util.go 文件中可见
​
func Help() string {
return helper // 只有在同一个文件中定义的函数可以访问 helper
}

这里的变量 helper 仅在定义它的文件 util.go 内可见。

"if", "for", 和 "switch" 语句块(Implicit block)​

在这些控制流语句中定义的变量仅在语句块内部有效。

package main
​
import "fmt"
​
func main() {
if x := 10; x > 5 {
fmt.Println(x) // x 在这个 if 块中有效
}
// fmt.Println(x) // 这里访问 x 会报错,因为 x 的作用域仅在 if 块内
}

"switch" 或 "select" 语句中的每个子句(Implicit block)​

在每个 switch 或 select 的子句中定义的变量仅在该子句内有效。

 package main
​
import "fmt"
​
func main() {
switch num := 5; {
case num < 10:
fmt.Println(num) // num 在这个 case 块中有效
}
// fmt.Println(num) // 这里访问 num 会报错,因为 num 的作用域仅在 switch 的 case 块内
}

Go make 和 new 的区别

· 阅读需 2 分钟
素明诚
Full stack development

对比 new 和 make​

对比项newmake
函数功能分配内存并返回指向零值的指针分配内存并返回初始化的引用类型实例
返回类型指针引用类型实例(非指针)
使用类型所有类型切片、映射、通道
初始化内存初始化为零值内存初始化为特定的非零值(如切片的结构信息)
场景需要类型零值的指针时使用需要立即使用的切片、映射或通道

new 函数适用于所有类型,它分配内存并返回一个指向零值的指针。它适用于你只需要一个指向某类型零值的指针的场景。

make 函数专用于切片、映射和通道这些内建的引用类型,它不仅分配内存,还负责初始化这些类型的内部数据结构,使得实例可以立即使用。

理解零值​

比如说,如果你执行 ptr := new(int),ptr 是一个指向 int 类型的指针

  • ptr 指向的内存区域包含的 int 值被初始化为 0(int 类型的零值)。
  • 因此,*ptr == 0 将返回 true,因为 ptr 指向的 int 值是其零值。

如果是 ptrStruct := new(MyStruct),其中 MyStruct 是一个包含多个字段的结构体

  • 每个字段都会被初始化为相应类型的零值。如果有整型字段,它们会被设置为 0;如果有字符串字段,它们会被设置为空字符串 "";如果有指针字段,它们会被设置为 nil。
  • 所以,ptrStruct 指向的 MyStruct 实例在所有字段上都体现了各自类型的零值。

注意事项​

new 的使用​

  • 零值误解:新手可能会误解 new 创建的是已初始化的对象,尤其是复杂的结构体。
  • 引用类型字段:new 创建的结构体中的切片、映射或通道字段默认为 nil,需要额外的初始化步骤。

make 的使用

  • 类型限制:make 仅适用于切片、映射和通道。
  • 初始化细节:容易混淆切片的容量和长度,可能导致内存浪费或逻辑错误。