跳到主要内容

修改 Go Module 代理

· 阅读需 2 分钟
素明诚
Full stack development

bash 设置 Go 代理​

要设置 Go 代理,你可以使用 go env 命令来设置环境变量。例如,使用七牛云的 Go 代理可以通过以下命令设置:

export GOPROXY=https://goproxy.cn,direct

这条命令设置了 Go 代理服务器地址为 https://goproxy.cn,并且如果在该代理服务器上找不到所需模块,Go 工具链会尝试直接连接源服务器(direct)。

设置官方代理​

export GOPROXY=https://proxy.golang.org,direct

检查设置​

go env GOPROXY

PowerShell(管理员) 设置 Go 代理​

setx GOPROXY "https://goproxy.cn,direct" /M

检查设置​

echo %GOPROXY%

七牛云 Go Module 代理​

地址:https://goproxy.cn

特点:七牛云提供的服务,稳定可靠,被广泛推荐使用。

阿里云 Go Module 代理​

地址:https://mirrors.aliyun.com/goproxy/

特点:由阿里云提供,服务稳定,接入阿里云生态。

腾讯云 Go Module 代理​

地址:https://mirrors.cloud.tencent.com/go/

特点:由腾讯云提供,服务稳定,速度快。

注意事项​

确保你使用的 Go 版本支持模块(Go 1.11 及以上版本)。

设置代理后,所有通过 go get 等命令获取的 Go 包都会通过代理服务器下载。

Go 语言的官方包文档网站​

https://pkg.go.dev

包搜索功能:用户可以通过搜索框输入包名或关键词来查找对应的 Go 包。

文档浏览:为每个包提供详细的 API 文档,包括函数、类型、变量等的说明。

版本历史:展示包的版本历史和各个版本的详细变更记录。

许可证信息:显示包的许可证类型,帮助开发者了解如何合法使用包。

导入统计:提供包的导入次数和依赖关系图,帮助开发者了解包的流行程度和关键性。

Go 项目使用 Alpine 构建镜像

· 阅读需 2 分钟
素明诚
Full stack development

示例 Dockerfile​

Go 应用能够在 Alpine Linux 上运行,你需要确保它完全静态链接,即不依赖于任何外部的动态链接库

FROM golang:1.22.2 AS build2
​
WORKDIR /gin-blog
​
# 设置环境变量,确保 Go 模块被启用,CGO 被禁用,并指定操作系统为 Linux
ENV GO111MODULE=on \
CGO_ENABLED=0 \
GOOS=linux
​
# 设置 Go 代理,以便能够下载依赖
ENV GOPROXY=https://goproxy.io,direct
​
# 下载所有依赖
RUN go mod download
​
# 使用特定的编译标志来构建应用
# -tags netgo:确保使用 Go 的纯 Go 网络栈
# -ldflags '-w -s -extldflags "-static"':减小生成的二进制文件的大小,并确保所有的链接都是静态的
RUN go build -tags netgo -ldflags '-w -s -extldflags "-static"' -o gin-blog

设置说明​

CGO_ENABLED=0

CGO 允许 Go 程序调用 C 代码。默认情况下,CGO 是启用的,这可能导致生成的可执行文件依赖于本地的 C 库,如 glibc 或 musl libc。在多数 Linux 发行版上,默认的 libc 是 glibc,而 Alpine 使用的是 musl libc,两者在某些实现和行为上有差异。禁用 CGO 并启用纯 Go 编译,可以生成完全静态链接的二进制文件,不依赖于操作系统的 C 库,从而提高在不同 Linux 发行版(特别是在使用 musl libc 的 Alpine Linux)上的兼容性。

GOOS=linux: 这告诉 Go 编译器,目标操作系统是 Linux

-tags netgo: 这个编译标志确保 Go 使用其自身的网络库,而非系统级的网络库这是为了避免依赖系统的动态网络库,特别是在静态编译的情况下

-ldflags '-w -s -extldflags "-static"'

  • -w -s 用来减少编译后的二进制文件的大小,通过去除调试信息
  • -extldflags "-static"' 确保链接过程中不链接任何动态库,即使是系统的 libc

JWTpayload字段解释

· 阅读需 1 分钟
素明诚
Full stack development

注册的 Claims​

字段名描述类型
iss发行人字符串
sub主题字符串
aud接收方字符串
exp过期时间时间戳
nbf在此之前不可用时间戳
iat发行时间时间戳
jtiJWT ID字符串

公共的 Claims​

公共的 claims 可以被定义用于公共或私有的信息交换。为了避免冲突,它们应该在 IANA JSON Web Token Registry 中注册,或者包含一个命名空间以防止命名冲突。

私有的 Claims​

私有的 claims 是发送者和接收者之间共同定义的 claims,并不是注册或公共的 claims。这些 claims 通常用于携带业务逻辑相关的信息。

什么是倒排索引Inverted Index

· 阅读需 4 分钟
素明诚
Full stack development

假设淘宝上有以下三个商品描述,我们将建立每个词对应的文档列表,如下表所示

商品 1:苹果手机新款发布,支持 5G 网络

商品 2:小米最新 5G 智能手机,性能卓越

商品 3:华为 5G 网络手机,实际 4G 功耗所以续航时间长

构建倒排索引​

对每个商品的描述进行分词和处理后,构建如下的倒排索引

词汇商品 ID 列表
苹果1
手机1, 2, 3
新款1
发布1
支持1
5G1, 2, 3
网络1, 3
小米2
最新2
智能2
性能2
卓越2
华为3
实际3
4G3
功耗3
续航3
时间3
长3

用户实际搜索​

当用户在淘宝搜索“5G 手机”时,搜索系统会进行以下操作:

分词:将“5G 手机”分解为“5G”和“手机”

查找索引:查询倒排索引,找到含有“5G”和“手机”的商品 ID

  1. “5G”对应商品 1, 2
  2. “手机”对应商品 1, 2, 3

合并结果:由于两个词的搜索结果相同,返回商品 1, 2

排序和展示:基于其他因素(如商品评分、销量等)对搜索结果进行排序,并展示给用户

存储和查找​

存储:对于需要极高读取性能的应用,倒排索引可以存储在内存中的数据结构,如Redis或者是 map 这种数据结构也可以存储在分布式文件系统Hadoop,或者是搜索引擎专用的Elasticsearch

查找:内存数据库提供极快的数据访问速度,适用于实时搜索和高频访问场景

倒排索引的构建过程​

1.文档预处理​

去噪声:移除文档中的 HTML 标签、特殊符号、数字等无关内容

标准化:统一文档的格式,如将所有文字转换为小写,统一使用的日期和数字格式等

2.分词(Tokenization)​

分词:中文文本的分词比英文复杂,因为中文没有明显的词与词之间的空格分隔因此,需要使用专门的中文分词工具来识别中文句子中的词汇,如结巴分词(jieba)、汉语言处理包(HanLP)等

词干提取(Stemming):将词汇还原为基本形式(例如,“running”还原为“run”)

去停用词:中文的停用词(如“的”、“了”、“在”等)需要特别处理,因为这些词在中文中非常常见,但通常不携带重要信息

编码:确保处理和存储过程中使用统一的字符编码(如 UTF-8),这对于处理中文等多字节语言尤为重要,以防出现乱码问题

查询处理:在处理查询时,同样需要对查询文本进行分词处理,确保查询词与索引中的词能够正确匹配

3.构建倒排记录​

创建倒排记录:对于每一个分词,创建一个记录,记录中包含该词出现的所有文档 ID 以及该词在每个文档中的位置

记录更新:随着新文档的添加,不断更新每个词的倒排记录

4.索引存储​

索引格式化:将倒排索引以某种格式(如哈希表、B 树)存储在文件或数据库中

压缩:为了节省存储空间和提高查询效率,倒排索引通常会被压缩常用的压缩技术包括编码文档 ID 差值、使用位运算等

5.优化和维护​

索引优化:定期优化索引结构,合并小索引文件,删除无用索引,以提高搜索效率

动态更新:支持索引的实时更新,以反映内容的变化

6.索引使用​

查询处理:接收用户查询,解析查询词,通过倒排索引快速找到包含这些词的文档

排名算法:基于文档中词的频率、位置等因素对搜索结果进行排名

Go 实现简单倒排索引​

package algorithm

type Doc struct {
Id int
Keywords []string
}

func BuildInvertedIndex(docs []Doc) map[string][]int {
index := make(map[string][]int)
for _, doc := range docs {
for _, keyword := range doc.Keywords {
index[keyword] = append(index[keyword], doc.Id)
}
}
return index
}

常见的访问控制模型和表结构

· 阅读需 7 分钟
素明诚
Full stack development

RBAC(Role-Based Access Control)​

在一所大学的信息系统中,根据用户的角色(如学生、教授、行政人员)分配不同的访问权限。教授可以访问和修改课程成绩,学生只能查看成绩和课程资料,行政人员可以访问学生记录和财务信息。

表结构

表名字段说明
UsersUserID, UserName用户表
RolesRoleID, RoleName角色表
PermissionsPermissionID, PermissionDescription权限表
UserRoleUserID, RoleID用户角色关系表
RolePermissionRoleID, PermissionID角色权限关系表

关系说明

  • 用户与角色是多对多关系,通过 UserRole 表联系
  • 角色与权限是多对多关系,通过 RolePermission 表联系

查询语句: 查询一个用户的所有权限

SELECT PermissionDescription FROM Permissions
JOIN RolePermission ON Permissions.PermissionID = RolePermission.PermissionID
JOIN UserRole ON RolePermission.RoleID = UserRole.RoleID
WHERE UserRole.UserID = [用户ID];

ABAC(Attribute-Based Access Control)​

在一个智能家居系统中,系统根据时间、地点以及设备状态控制家居设备的访问例如,只有家庭成员在家时,才能通过手机应用控制家中的安全系统

表结构

表名字段说明
DevicesDeviceID, DeviceType设备表
PoliciesPolicyID, PolicyRule, Effect策略表,定义访问条件和效果
AttributesAttributeID, DeviceID, AttributeName, AttributeValue设备属性表

关系说明

  • 设备具有多个属性,属性表通过 DeviceID 与设备表关联
  • 策略定义了基于属性的访问规则

查询语句: 检查是否允许访问设备

SELECT Effect FROM Policies
WHERE PolicyRule = 'DeviceType = "SecuritySystem" AND AttributeName = "Status" AND AttributeValue = "AtHome"'
AND DeviceID = [设备ID];

ACL(Access Control List)​

在公司的文件共享服务器上,管理员为不同的文件夹设置 ACL,规定哪些部门或个人有读取或编辑文件的权限,以此来保护敏感数据不被未授权访问

表结构

表名字段说明
FilesFileID, FileName文件表
UsersUserID, UserName用户表
FilePermissionsFileID, UserID, PermissionType文件权限表

关系说明

  • 文件与用户之间的权限关系通过 FilePermissions 表定义

查询语句: 查询某个用户对文件的权限

SELECT FileName, PermissionType FROM Files
JOIN FilePermissions ON Files.FileID = FilePermissions.FileID
WHERE FilePermissions.UserID = [用户ID];

DAC(Discretionary Access Control)​

在操作系统中,用户可以设置个人文件的权限,决定哪些其他用户可以访问或修改这些文件,如在家庭电脑上父母可以访问孩子的学习资料文件夹

表结构

表名字段说明
UsersUserID, UserName用户表
FilesFileID, FileName, OwnerID文件表,包含所有者 ID
FilePermissionsPermissionID, FileID, UserID, PermissionType文件权限表,定义用户对文件的权限

关系说明

  • 文件有一个所有者,所有者通过 OwnerID 与用户表关联
  • 用户对文件的访问权限通过 FilePermissions 表定义,权限类型包括读取、写入等

查询语句: 查询用户对文件的权限

SELECT FileName, PermissionType FROM Files
JOIN FilePermissions ON Files.FileID = FilePermissions.FileID
WHERE FilePermissions.UserID = [用户ID];

MAC(Mandatory Access Control)​

在军事或政府通信系统中,根据信息的安全级别(如机密、秘密、公开)决定谁可以访问这些信息,确保只有具有相应安全级别的人员才能访问

表结构

表名字段说明
UsersUserID, UserName, ClearanceLevel用户表,包含安全级别
DocumentsDocumentID, SecurityLevel文档表,包含文档安全级别
AccessRulesRuleID, MinClearanceLevel, DocumentID访问规则表

关系说明

  • 文档具有特定的安全级别,用户访问需满足最低安全级别要求
  • 访问规则定义了文档的最低清除级别

查询语句: 查询用户可以访问的所有文档

SELECT DocumentID FROM Documents
JOIN AccessRules ON Documents.DocumentID = AccessRules.DocumentID
WHERE AccessRules.MinClearanceLevel <= (SELECT ClearanceLevel FROM Users WHERE UserID = [用户ID]);

PBAC(Policy-Based Access Control)​

在健康管理应用中,可以设置策略允许医生访问他们患者的医疗记录,但禁止访问其他患者的信息,除非在紧急情况下得到授权

表结构

表名字段说明
UsersUserID, UserName用户表
RecordsRecordID, PatientID医疗记录表
AccessPoliciesPolicyID, UserID, RecordID, Conditions, Effect访问策略表

关系说明

  • 访问策略表定义了在特定条件下用户可以访问的记录
  • 策略可能包含条件,如“只有紧急情况”或“只有是主治医生”

查询语句: 查询医生可以访问的医疗记录

SELECT RecordID FROM Records
JOIN AccessPolicies ON Records.RecordID = AccessPolicies.RecordID
WHERE AccessPolicies.UserID = [用户ID] AND Conditions = 'Emergency';

RB-RBAC (Rule-Based Role-Based Access Control)​

在金融机构中,高级管理人员可以查看所有财务报告,而普通员工只能在完成相关培训并被授权后,才能访问特定的财务数据

表结构

表名字段说明
UsersUserID, UserName用户表
RolesRoleID, RoleName角色表
RulesRuleID, RoleID, RuleCondition规则表,包含条件
RoleRulesRoleID, RuleID角色规则关联表
PermissionsPermissionID, Description权限表
RolePermissionsRoleID, PermissionID角色权限关联表

关系说明

  • 角色通过 RoleRules 与规则关联
  • 角色与权限通过 RolePermissions 表关联

查询语句: 查询用户角色的权限

SELECT Description FROM Permissions
JOIN RolePermissions ON Permissions.PermissionID = RolePermissions.PermissionID
JOIN Roles ON RolePermissions.RoleID = Roles.RoleID
JOIN Users ON Roles.RoleID = Users.UserID
WHERE Users.UserID = [用户ID];

SCAC(Social Context-Aware Access Control)​

在社交媒体平台上,用户可以设置隐私控制,允许只有特定的好友列表(如亲密好友)可以查看其个人照片或动态

表结构

表名字段说明
UsersUserID, UserName用户表
PostsPostID, Content, PrivacySetting帖子表,包含隐私设置
FriendListsListID, UserID, FriendID好友列表表
ListPermissionsListID, PostID, PermissionType列表权限表

关系说明

  • 帖子的可见性由 PrivacySetting 定义,与 FriendLists 表中的列表匹配
  • 用户通过 FriendLists 定义自己的社交圈

查询语句: 查询用户可以看到的帖子

SELECT PostID FROM Posts
WHERE PrivacySetting = 'FriendsOnly' AND PostID IN (
SELECT PostID FROM ListPermissions
JOIN FriendLists ON ListPermissions.ListID = FriendLists.ListID
WHERE FriendLists.FriendID = [用户ID]
);

结合 RBAC 和 ABAC​

在许多企业级应用中,RBAC(角色基于访问控制)通常与ABAC(基于属性的访问控制)结合使用来提供更灵活的访问控制策略例如,一个系统可能基于用户的角色(如经理或员工)授予权限,同时根据其他属性(如地理位置、访问时间或设备安全状态)对权限进行细粒度的调整这种组合允许系统在维持角色管理的简便性的同时,增加基于环境或上下文的安全策略

结合 DAC 和 MAC​

在需要极高安全级别的环境中,DAC(自主访问控制)和MAC(强制访问控制)可以同时使用例如,在政府或军事系统中,文件的创建者可以设置自己的访问控制列表(DAC 模式),同时系统还会强制执行根据文件分类和用户安全级别的访问控制(MAC 模式)这样,即使文件的创建者给予了访问权限,只有符合安全级别要求的用户才能实际访问文件

结合 PBAC 和 RBAC​

PBAC(基于策略的访问控制)经常与RBAC结合使用,尤其是在复杂的业务逻辑需要映射到访问控制策略时在这种情况下,角色定义基本的访问权限,而策略则可以根据业务规则进一步调整这些权限例如,在医疗信息系统中,所有医生可能基于他们的角色拥有访问病人信息的权限,但基于政策,只有主治医生才能访问敏感的治疗历史,且仅在病人住院期间

算法中的大O表示法Big O notation

· 阅读需 3 分钟
素明诚
Full stack development

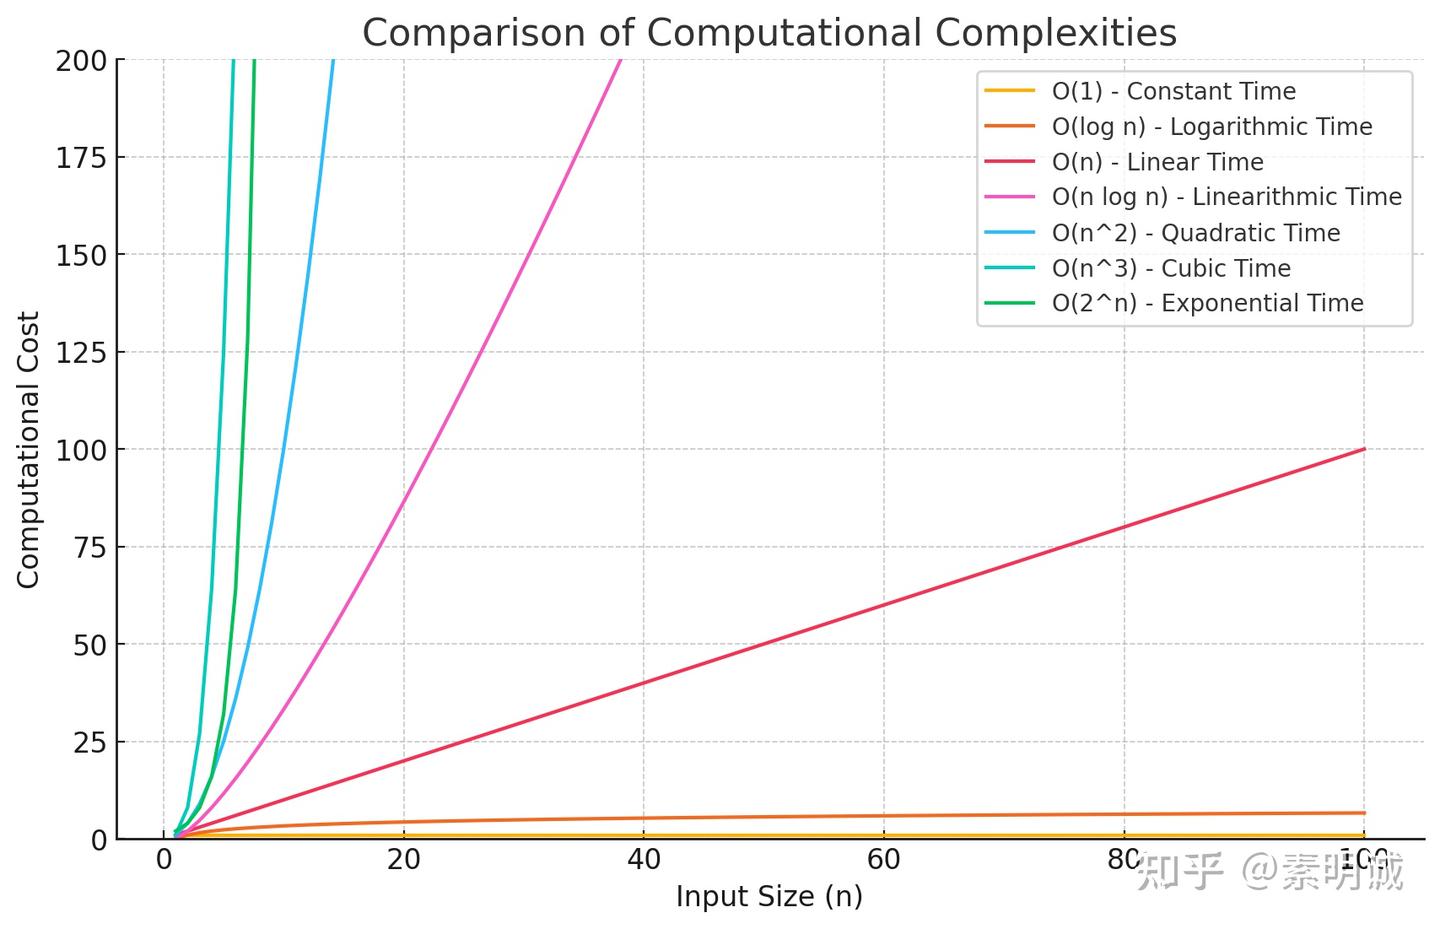
大 O 表示法(Big O notation)源自数学中的“渐进符号”,用来描述函数当输入值趋向无穷大时的增长率 在算法分析中,我们通常关注最坏情况的时间复杂度,即输入数据量极大时,算法执行时间的上界

这种表示法的重点是帮助我们抽象化算法的性能,忽略具体实现的细节和低阶增长,只关注主导行为 例如,一个算法的时间复杂度可能是 3n^2 + 5n + 7,但我们会用 O(n^2) 来描述它,因为当 n 足够大时,n^2 项是决定性因素

通过这种方式,大 O 表示法为算法设计和分析提供了一个清晰、一致的框架,使得不同算法间的比较和选择更加基于理论和数学基础,而不仅仅是经验 这有助于在实际应用中优化性能和资源使用

不考虑的因素​

具体执行时间:大 O 不关心算法执行的具体秒数,因为这受到太多外部因素的影响,如处理器速度、系统负载、编译器优化等

系数和低阶项:在大 O 表示法中,忽略系数和低阶项是因为它们对于大规模数据的影响较小

常数时间:即使某些操作(如数据复制、移动等)在实际执行中需要时间,大 O 分析中常常假设这些操作的时间是常数,并聚焦于变化最显著的部分

b05eef6228a03d66e8ceaecd60db87db## Go 语言示例

O(1) - 常数时间复杂度​

操作的执行时间不依赖于输入数据的大小 例如,访问数组中的特定元素

func getFirstElement(elements []int) int {
return elements[0] // 总是返回数组的第一个元素
}

O(log n) - 对数时间复杂度​

通常见于“分而治之”的策略,如二分搜索

func binarySearch(slice []int, target int) int {
low := 0
high := len(slice) - 1
​
for low <= high {
mid := low + (high-low)/2
if slice[mid] < target {
low = mid + 1
} else if slice[mid] > target {
high = mid - 1
} else {
return mid
}
}
return -1
}

O(n) - 线性时间复杂度​

操作的执行时间与输入数据的大小成正比 例如,计算所有元素的总和

func sumElements(elements []int) int {
sum := 0
for _, v := range elements {
sum += v
}
return sum
}

O(n log n) - 线性对数时间复杂度​

常见于某些高效的排序算法,如归并排序

func merge(left, right []int) []int {
result := make([]int, 0, len(left)+len(right))
for len(left) > 0 && len(right) > 0 {
if left[0] < right[0] {
result = append(result, left[0])
left = left[1:]
} else {
result = append(result, right[0])
right = right[1:]
}
}
result = append(result, left...)
result = append(result, right...)
return result
}
​
func mergeSort(elements []int) []int {
if len(elements) < 2 {
return elements
}
mid := len(elements) / 2
return merge(mergeSort(elements[:mid]), mergeSort(elements[mid:]))
}

静态链接库Static Libraries和动态链接库Dynamic Libraries

· 阅读需 3 分钟
素明诚
Full stack development

静态链接库​

在编译阶段,静态库的内容直接复制到最终的可执行文件中 一旦程序被编译,它就包含了所有它需要的代码和资源,无需外部库文件

优点​

自包含 可执行文件包含所有必需的库代码,便于分发

启动性能 无需在运行时加载外部库,可能提高加载速度

缺点​

文件大小 可执行文件较大,因包含了所有库代码

更新困难 库更新后,所有使用该库的应用都需重新编译和分发

动态链接库​

动态库在程序运行时被加载 可执行文件包含库的引用,实际的库代码在运行时才载入内存 多个程序可以共享同一份库副本

优点​

节省空间 多个程序可共享单一库副本

更新容易 更新库文件后,所有使用该库的程序自动受益

缺点​

依赖性 必须确保运行时库可用,否则程序无法启动

性能开销 加载库可能增加程序启动时间,运行时解析也可能轻微影响性能

举例说明​

如果你的程序需要进行数学计算,如求平方根,你可能会使用数学库(比如 C 语言的 math.h)

静态链接 在编译时,math.h 提供的函数直接被复制到你的可执行文件中,使得程序不需要在系统中查找数学库

动态链接 程序保留对数学库函数的引用,不直接包含这些代码 当程序运行时,操作系统加载这些函数的动态库(如 libm.so) 如果其他程序也使用这些函数,它们可以共享同一份 libm.so

go 创建静态链接的可执行文件​

下面是创建一个静态链接的 Go 程序的一般步骤和指令

# 设置 CGO_ENABLED=0 禁用 CGO
CGO_ENABLED=0
​
# 使用 go build 命令并加入适当的标志
go build -tags netgo -ldflags '-extldflags "-static"'

参数说明​

CGO_ENABLED=0

禁用 CGO,确保不调用任何 C 代码库,这是实现纯静态链接的关键

-tags netgo

确保 Go 使用其自己的网络库(net package)实现,而不是系统的网络库。这有助于在网络操作中也保持静态链接,尤其是 DNS 解析相关功能

-ldflags '-extldflags "-static"'

静态链接。-extldflags "-static" 是传递给外部链接器的,确保没有动态库被链接

Linux 安装 Go 配置环境变量

· 阅读需 1 分钟
素明诚
Full stack development

下载​

wget https://studygolang.com/dl/golang/go1.22.4.linux-amd64.tar.gz

解压​

sudo tar -C /usr/local -xzf go1.22.4.linux-amd64.tar.gz

bash​

nano ~/.bashrc

# Go 环境变量设置
export GOROOT=/usr/local/go
export GOPATH=/usr/local/go-env
export GOPROXY=https://goproxy.cn,direct
export PATH=$PATH:/usr/local/go/bin

source ~/.bashrc

zsh​

nano ~/.zshrc

# Go 环境变量设置
export GOROOT=/usr/local/go
export GOPATH=/usr/local/go-env
export GOPROXY=https://goproxy.cn,direct
export PATH=$PATH:/usr/local/go/bin

source ~/.zshrc

测试​

检查 Go 语言的版本和环境变量

go version
go env

通过包管理器安装​

sudo apt install golang-go

pnpm 将子项目作为依赖引入项目

· 阅读需 2 分钟
素明诚
Full stack development

创建和配置 pnpm 工作空间​

创建 pnpm-workspace.yaml 文件: 在项目的根目录下创建一个 pnpm-workspace.yaml 文件,用于指定包含的子项目路径。

packages:
- 'packages/*'

这告诉 pnpm,packages 文件夹下的每个子目录都是单独的项目,并应该被视为工作空间的一部分。

初始化子项目: 确保每个子项目目录下都有自己的 package.json 文件。这些 package.json 文件应定义各自的依赖和脚本。

安装和管理依赖​

安装依赖: 在根目录执行 pnpm install 命令。这会根据 pnpm-workspace.yaml 的配置为所有子项目安装依赖,并在根目录的 node_modules 中创建必要的符号链接。

添加跨项目依赖: 如果你想在一个子项目中使用另一个子项目作为依赖,可以在 package.json 中使用 workspace: 协议。例如,如果 projectA 依赖于 projectB,则 projectA 的 package.json 应写为

{
"dependencies": {
"projectB": "workspace:*" // 注意这个 projectB 就是你子项目的文件夹名字
}
}

这告诉 pnpm 从当前工作空间中找到 projectB 并将其链接到 projectA。

构建和运行项目​

构建项目: 根据每个项目的配置,运行相应的构建命令。你可以在根目录下使用 pnpm run --filter <project-name> build 来针对特定项目运行构建脚本。

开发中的项目互用: 使用工作空间协议 workspace:* 允许你在开发中实时链接子项目,任何在依赖项目中的改动都会立即反映到使用该依赖的项目中。

Git 提交规范之 commit 标题

· 阅读需 1 分钟
素明诚
Full stack development

用于说明 commit 的类别,只允许使用以下标识​

commit 的简短描述,一般来说不超过 50 个字符

feat (新功能)​

feat(search): Implement full-text search using Elasticsearch

feat(payment): Integrate Stripe for processing payments

feat(sharing): Add social media sharing buttons to product pages

feat(localization): Support multi-language content

fix (修复问题)​

fix(memory-leak): Patch memory leak observed in image processing

fix(security): Sanitize user input to prevent SQL injection

fix(crash): Resolve app crash related to zero-length data parsing

fix(ui-render): Fix broken layout on mobile devices in landscape mode

docs (文档改动)​

docs(installation): Revise steps to clarify the setup process

docs(contributing): Update contribution guidelines to include code review practices

docs(faq): Expand the FAQ section to cover newly reported issues

docs(license): Correct the copyright year in license documentation

style (格式调整)​

style(sass): Convert CSS files to Sass for easier maintenance

style(indentation): Normalize indentation across all JavaScript files

style(variable-naming): Refactor to follow camelCase naming convention

refactor (代码重构)​

refactor(auth-module): Decouple authentication from user management

refactor(api-responses): Standardize API responses to use a common format

refactor(logging): Enhance logging mechanism for better scalability

refactor(component-split): Break down the monolithic MainPage component into smaller units

test (测试相关)​

test(deployment): Add pre-deployment smoke tests to the pipeline

test(performance): Implement new benchmarks for recent optimizations

test(accessibility): Conduct accessibility audits and address issues

test(integration): Increase coverage for integration testing between modules

chore (杂项)​

chore(update-framework): Update frontend framework to latest stable version

chore(cleanup-deps): Remove unused dependencies to reduce build size

chore(data-migration): Script data migration for next database schema update

chore(ci-config): Modify CI configuration to include new test suites